为什么先做方法学顶层设计?
数据库不是把数据堆在一起。先要梳理研究需求——现有课题方向、诊疗中发现的临床问题、指南空白、流行病学与卫生经济学问题、预测模型与工具开发等,再确定研究设计类型、研究对象、样本量估算和关键变量集合,制定数据收集标准与质量控制方案。
诊疗数据为什么不能直接用于科研?
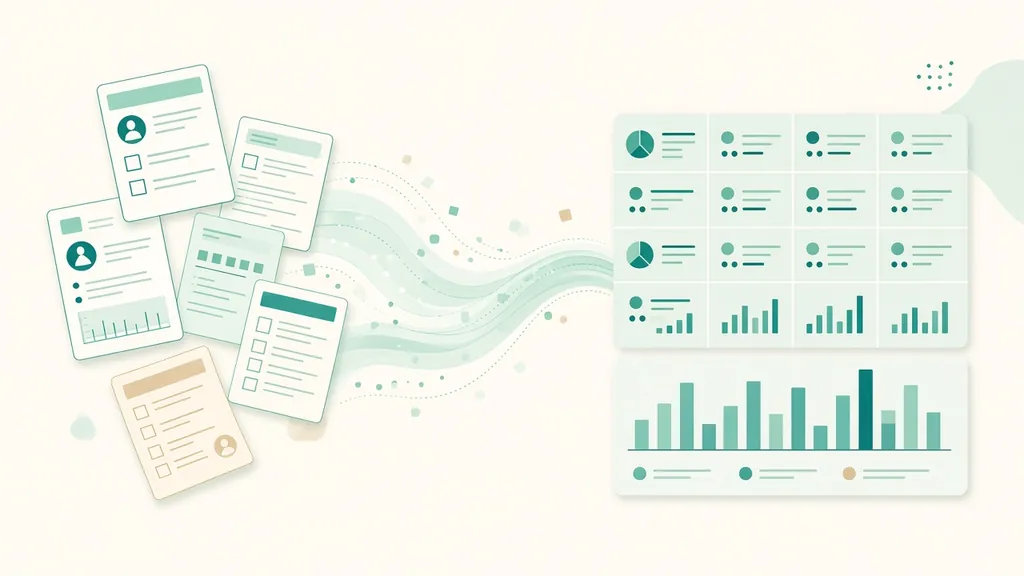
门诊、检验、住院与病历资料分散在多个系统里;患者多次就诊、多次检查、多次住院;诊疗体系不标准,大量信息是非结构化文字,容易重复和遗漏。需要基于医学知识、科研理解与 NLP 技术做智能化清洗,得到关键核心变量齐全、逻辑关系清晰、颗粒度细的结构化数据集。
什么是复杂变量加工?
有些变量无法从单一字段读出。以“术后感染”为例,需要综合医嘱(有无高阶抗生素使用)、检验(血培养、引流液 / 腹水培养)、血常规(白细胞)以及培养时间(术后 5 天以内或以上)等信息,按专家确认的规则组合判断,得出“术后感染、轻度术后感染、无术后感染”。规则由专家确认,存疑记录人工复核。
数据集标准包括什么?
按人口学信息、现病史、既往史、个人史、家族史、体格检查、实验室检查、影像学检查、病理与免疫组化、诊断、治疗、就诊信息、随访信息、不良反应等类别定义变量,并统一编码——比如性别在不同系统里可能记为 0/1 或 male/female,入库前必须统一。
多中心建库要注意什么?
主中心与分中心按同一标准采集数据;一段时间内可通过调查问卷连续收集患者信息,用 NLP 把非结构化数据转为科研数据,再建立研究队列、提取并导出队列数据。
数据库建好后,预测模型怎么做?
以骨髓炎预测模型为例:先通过文献分析、大数据分析和多轮德尔菲专家法确定风险点;再用神经网络、随机森林、决策树等方法构建评分模型,同时用传统方法构建对照模型;用层次分析法确定风险权重;最后绘制混淆矩阵、ROC 曲线等,评估临床应用价值。
常见问题
专病数据库一定要多中心吗?
不一定。单中心也可以起步,关键是标准统一,便于后续扩展。
NLP 提取的数据可以直接用吗?
不建议。提取结果需要按规则校验,存疑记录要人工复核。
专病数据库和 Agent 有什么关系?
专病数据库是 Agent 的“记忆”与数据底座;病历数据提取与变量加工本身也可以做成 Agent。
本文由芥舟医学内容团队根据既往项目经验整理,仅供方法交流,不构成医疗建议。